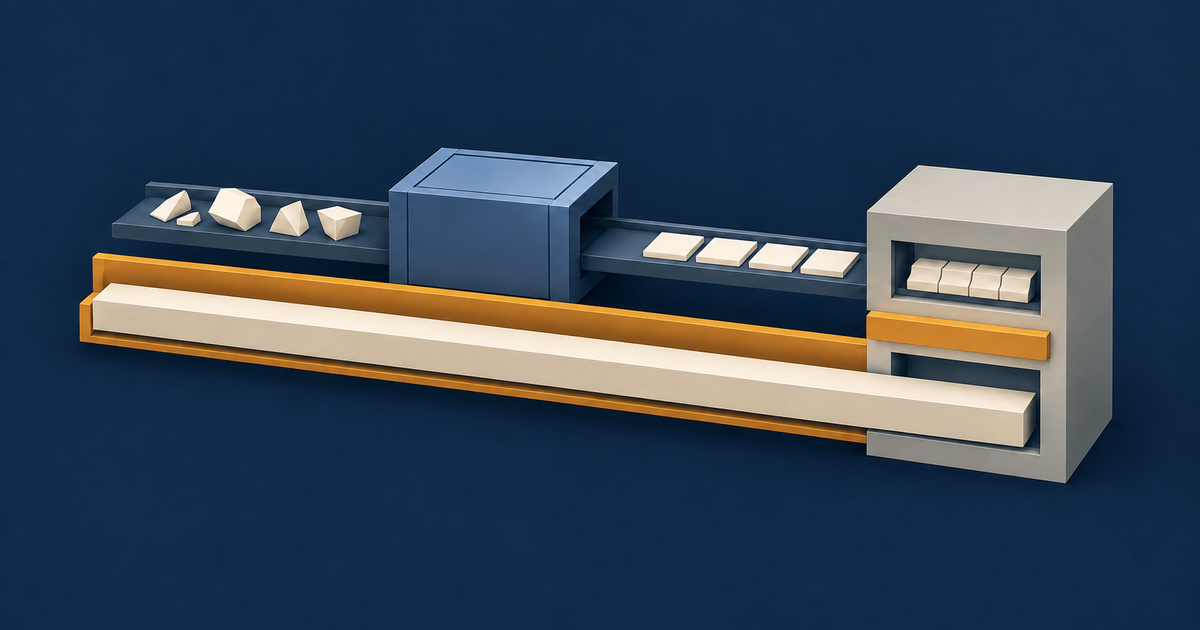
В моём проекте uo-request-generator житель описывает бытовую проблему, а приложение готовит текст заявки для управляющей организации. Модель нужна, чтобы превратить разговорное сообщение в компактное и понятное описание. Отправляет заявку сам пользователь.1
При подготовке публичной беты возникла более узкая задача: не позволять модели превращать наблюдение в неподтверждённое техническое требование. Сообщение о неработающем освещении ещё не объясняет, что сломалось и какие детали нужно менять.
Решение состояло не только в проверке ответа. Пришлось определить, какие части заявки модель вообще должна создавать. Описание осталось генеративным, а пункт с требованием к управляющей организации перешёл под управление обычного кода.
Правильная форма не доказывает правильный смысл
Структурированный вывод (Structured Outputs) позволяет ограничить ответ JSON-схемой: определить поля, типы и допустимые значения. Это сильнее просьбы «верни JSON», но не проверка истинности содержимого. В документации OpenAI отдельно указано, что структурированный ответ всё ещё может содержать ошибки. Отказы модели и незавершённые ответы также требуют отдельной обработки.2
Рассмотрим условный пример, не результат реального запуска. Пользователь написал:
С потолка в общем коридоре капает вода.
В поле problem модель могла бы вернуть «В общем коридоре с потолка капает вода». А могла бы — «Из-за повреждения кровли в общем коридоре протекает потолок».
Для схемы, которая ограничивает это поле непустой строкой допустимой длины, оба значения корректны. Во втором появился источник протечки, которого пользователь не устанавливал. Проверка типа строки не отличит его от переданного факта.
С требованиями возникает та же проблема. Строка «Заменить повреждённый участок кровли» может пройти структурную проверку и при этом оказаться выдуманным способом ремонта. Поэтому вопрос «соответствует ли ответ схеме?» пришлось отделить от вопроса «почему этот компонент вправе сформировать такое требование?».
Точная цитата тоже не решает задачу целиком
В поиске решения появился промежуточный вариант с закрытыми процедурными ролями. Модель должна была выбирать операции вроде установления причины, устранения проблемы и проверки результата. Для обоснования выбора она ссылалась на точные фрагменты пользовательского ввода, а приложение собирало текст по этим решениям.
В исторической версии ADR этот вариант имеет статус Proposed. Это важно: его нельзя описывать как уже действовавшую защиту публичного сервиса.3
Идея ограничивала произвольный текст в требованиях. Но оставляла за моделью смысловой выбор: какой фрагмент относится к какой операции и достаточно ли его для такого решения.
В том же ADR разобран синтетический пример:
Петли исправны, ручка отсутствует.
Проверка может доказать, что слова «петли» и «ручка» присутствуют в исходном сообщении. Но если модель выберет «петли» как отсутствующий элемент, точное совпадение не сделает выбор правильным. Для этого нужно понять отрицание и связь между частями фразы.
Происхождение текста — provenance — отвечает на вопрос «откуда взят фрагмент». Оно само по себе не отвечает на вопрос «допустимо ли использовать его в этой роли».
С пользовательскими требованиями возникала ещё одна сложность. Если поручить модели разрезать составное действие на фрагменты и распределить их между этапами, придётся отдельно проверять сохранение всех условий и отрицаний. Каждый выбранный фрагмент может быть дословным, а собранное из них требование — неполным.
Вместо усложнения проверки убрали часть задачи
Для беты был принят более простой контракт. Модель одним вызовом возвращает описательные поля, предмет проблемы, предупреждения и исход обработки. Пунктов требований в её выходной схеме нет. Это решение зафиксировано в актуальном ADR и реализовано в PR #246.4
Приложение формирует ровно один пункт раздела «Прошу:». Если пользователь заполнил отдельное поле desiredActions, используется весь его проверенный текст. Если поле отсутствует, подставляется общая формулировка «Устранить наблюдаемую проблему».
Ключевой выбор в реализации выглядит так:5
function buildRequestItems(input: GenerateRequestInput): [string] {
  return [
    input.desiredActions === undefined
      ? PRIMARY_REQUEST_GENERIC_ITEM
      : normalizeAuthoritativeRequestItem(input.desiredActions),
  ];
}
Нормализация здесь меняет представление, а не смысл. Она убирает пробелы по краям и один начальный префикс «Прошу:», заменяет переносы строк пробелами и безопасно переводит первую букву в прописную. Она не сокращает текст и не распределяет его по ролям. При сборке результата приложение добавляет оформление пункта и при необходимости завершающую пунктуацию.
В тестах есть требование:
Только провести осмотр, работы пока не выполнять.
Оно должно остаться единственным пунктом. Добавить рядом автоматическое «Устранить наблюдаемую проблему» означало бы изменить явно заданное ограничение. Поэтому общий пункт используется только при отсутствии desiredActions.
Один пункт не обязательно означает одно простое действие. Просьба проверить источник воды, устранить причину и затем проверить прекращение течи сохраняется целиком. Приложение не пытается решать, где заканчивается осмотр и начинается устранение.
У этого решения есть цена: без отдельного пользовательского требования результат менее конкретен. Зато для формирования этого пункта больше не нужно доверять модели ни выбор способа ремонта, ни сохранение частей составного действия.
Слово authoritative в имени функции не означает, что пользователь технически прав. Его текст является источником того, что он просит сохранить, а не доказательством правильности предлагаемого ремонта.
В ответе модели нет поля для подмены требования
Разделение закреплено в потоке данных, а не только в промпте. Выходная схема модели содержит описательные поля, но не requestItems. Схемы отклоняют дополнительные поля. Функция materializePrimaryRequestDraft отдельно получает проверенный ввод и ответ модели, а затем строит внутреннюю заявку.65
Получаются два пути:
ввод пользователя → LLM → проверенные по схеме описательные поля

проверенный desiredActions или общая фраза → единственный пункт «Прошу:»
При сборке внутреннего объекта requestItems берётся из второго пути. Приложение не просит модель сначала сформировать это поле, а затем подтвердить, что она ничего не изменила.
Это даёт конкретную структурную гарантию: выход модели не является источником пункта требований, который формирует приложение. Но гарантия относится именно к этому пункту, а не ко всему тексту заявки. Неподтверждённый ремонт всё ещё может появиться в генеративном описании. К этой границе я вернусь ниже.
Нормативный текст принадлежит приложению, но классификация остаётся риском
С нормативными основаниями используется похожее разделение. Тексты модулей заранее подготовлены и хранятся в коде. Модель не получает их для переписывания и не возвращает выбранный закон. Она классифицирует предмет проблемы и указывает фрагменты исходного ввода.1
Специальный нормативный модуль приложение добавляет только при выполнении нескольких условий: пользователь явно подтвердил предмет, классификация модели совпала с подтверждением, а каждая цитата дословно присутствует в указанном исходном поле. При отсутствии подтверждения, несовпадении предмета или непроверяемой цитате специальный модуль не подключается.7
Здесь нельзя сделать следующий шаг и объявить юридическую применимость доказанной обычным кодом. Проверка цитаты по-прежнему проверяет происхождение. Если пользователь и модель согласованно ошиблись в классификации, а цитаты действительно есть во вводе, эти условия сами по себе ошибку не обнаружат.
Граница уже: модель не сочиняет нормативный абзац, а приложение не подключает его без предусмотренных оснований. Корректность самих нормативных текстов и их обновление остаются отдельной обязанностью сопровождающего проект. Смысловая уместность классификации требует отдельной оценки.
Это различие не позволяет спрятать вероятностное решение за названием детерминированной функции. Функция может безошибочно сопоставить категорию с модулем, даже если категория выбрана неверно.
Контролируемый отказ имеет определённую область действия
Приложение не показывает невалидный или частичный ответ модели как готовую заявку. Переполнение допустимой длины результата также приводит к отказу, а не к молчаливому усечению требования. Это поведение закреплено в контракте и тестах.15
Но отсутствие специального нормативного модуля не обязательно означает отказ от всей заявки. Если остальные условия соблюдены, текст можно собрать без него. Защита должна останавливать именно то действие, для которого не выполнены условия допуска.7
Поэтому формулировка «система работает fail closed» без уточнения мало что объясняет. Нужно назвать границу: не принимается невалидный черновик, не подключается неподтверждённый модуль, не обрезается пользовательское требование ради успешного ответа.
Ни одна из этих проверок не обещает распознавать любую смысловую ошибку в описании. Структурно корректный текст может пройти дальше и остаться неверным по содержанию.
Генеративную часть всё равно нужно проверять
Полностью убрать свободную формулировку означало бы отказаться от основной задачи модели. В проекте она нужна именно для естественной нормализации бытового сообщения. Разные формулировки допустимы, пока сохраняются факты и смысл. Этот принцип отдельно закреплён в документации.8
Поэтому проверки разделены. Обычные тесты защищают то, что приложение обеспечивает кодом: источник пункта требований, сохранение условий и отрицаний, отсутствие дополнительного общего пункта, правила подключения нормативного модуля. Live eval и отдельное смысловое ревью проверяют оставшиеся генеративные риски: домыслы, потерю фактов, противоречия и неуместные предупреждения.59
Успешный прогон на наборе примеров не превращается в доказательство отсутствия ошибок на любом будущем вводе. Он даёт свидетельства о поведении конкретного варианта модели и приложения на проверенных сценариях.
Для меня результат этой работы — не способ полностью исключить ошибки LLM. Это более точное распределение ответственности. Там, где приложение может гарантировать сохранение явного пользовательского требования, незачем передавать его через генерацию и затем пытаться доказать, что смысл не изменился.
Перед расширением схемы теперь полезнее сначала спросить: зачем модели вообще принимать это решение? Иногда надёжнее не научить её лучше заполнять поле, а убрать это поле из её ответа.
README проекта на рассматриваемой ревизии. Здесь описана реализация, подготовленная к публичной бете, а не результаты эксплуатации публичного сервиса. ↩︎ ↩︎ ↩︎
OpenAI: Structured model outputs, разделы о соответствии схеме, отказах и ошибках содержимого. ↩︎
Промежуточный ADR-0004 со статусом Proposed. Пример с петлями и ручкой взят из раздела Exact evidence. ↩︎
Формирование требования в packages/core, сборка текста и регрессионные тесты. Примеры требований взяты из синтетических тестов, не из обращений жителей. ↩︎ ↩︎ ↩︎ ↩︎
Проверка условий и выбор нормативного модуля, функции
inputEvidenceMatchesиevaluateSpecificLegalBasisSelection. ↩︎ ↩︎